1. Introducció a NoSQL
L'objectiu d'aquesta unitat és conèixer les bases de dades NoSQL, una alternativa al model relacional per a determinats escenaris. Ens centrarem en les bases de dades documentals i, concretament, en MongoDB.
1.1. Què és NoSQL?
NoSQL no vol dir que no s'utilitze SQL, sinó No Only SQL (no sols SQL).
No és tant una qüestió de relacional o no relacional, sinó d'una estructura alternativa per a tractar les bases de dades davant un problema de rendiment.
És mirar la vessant relacional d'una base de dades des d'un altre punt de vista, amb una estructura més flexible i no tan limitant com el model relacional.
Els dos models apareixen en els anys 70-80. El relacional continua sent, a dia de hui, el més popular; NoSQL ha començat a ser-ho en els últims anys. NoSQL no és un substitut del relacional, sinó més aviat una alternativa en determinades circumstàncies.
1.2. Per què sorgeix?
NoSQL apareix amb la Web 2.0. Fins eixe moment, sols les grans companyies pujaven contingut a Internet. Però amb l'aparició de plataformes com Google, Amazon, Facebook, etc., qualsevol usuari podia pujar contingut, la qual cosa va provocar un increment enorme de les dades.
És en eixe moment quan comencen a aparèixer els primers problemes de rendiment en els sistemes de bases de dades relacionals:
- En un primer moment s'opta per ampliar el maquinari (HW), però era molt costós i no solucionava bé el problema.
- Finalment s'opta per crear un sistema específic per al problema: NoSQL.
NoSQL permet superar els problemes d'escalabilitat i rendiment que es produeixen en els sistemes relacionals quan hi ha grans volums de dades, gran quantitat d'usuaris en concurrència i milions de consultes diàries.
Aquests sistemes estan optimitzats per a tasques de recuperació i agregació d'informació; l'actualització no és la seua prioritat.
1.3. Principis NoSQL
NoSQL es basa en 4 principis:
Principis NoSQL
- El control transaccional ACID no és important.
- Els JOIN tampoc ho són, en especial els complexos i distribuïts.
- Alguns elements relacionals són necessaris i aconsellables: les claus (keys).
- Gran capacitat d'escalabilitat i de replicació en múltiples servidors.
1.4. Tipus de NoSQL
Les bases de dades NoSQL són sistemes d'emmagatzematge d'informació que no compleixen l'esquema Entitat-Relació ni l'estructura de taula en què s'emmagatzemen les dades. Aquests sistemes emmagatzemen la informació mitjançant:
- Clau-Valor
- Documents
- Mapeig de columnes
- Grafs
Atenció
- Les BD documentals (el nostre cas, MongoDB) emmagatzemen els documents com a estructures JSON.
- Les orientades a grafs componen un conjunt d'objectes anomenats nodes connectats mitjançant una sèrie d'arestes (per exemple, Neo4j).
- Les clau-valor emmagatzemen la informació en parells clau/valor (per exemple, Redis).
1.4.1. Clau-Valor
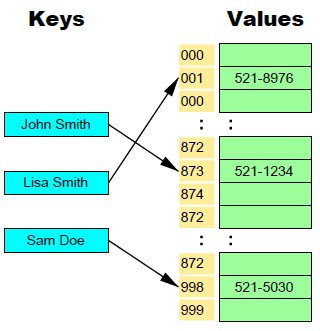
Són les més habituals en els SGBD NoSQL perquè són les més senzilles quant a funcionalitat.
En aquest sistema, cada element s'identifica per una clau única, la qual cosa permet una recuperació ràpida. Són molt eficients en lectura i escriptura.
Per exemple: Cassandra i Redis.
1.4.2. Documentals
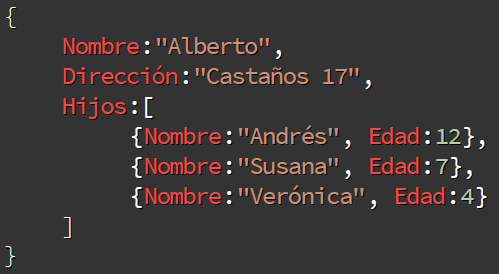
La informació s'emmagatzema com un document, utilitzant una estructura simple com JSON o XML. En cada registre s'utilitza una clau única.
A més de realitzar cerques per clau-valor, es poden fer cerques més avançades pel contingut del document.
Per exemple: MongoDB i CouchDB.
1.4.3. Grafs
La informació es representa com a nodes d'un graf i les seues relacions com les arestes entre els nodes, de manera que per recórrer la informació es pot aplicar la teoria de grafs.
Permet mantenir el rendiment, sense importar el que cresca la base de dades.
1.4.4. Mapeig de columnes
En aquest model les dades s'organitzen en columnes en lloc de files. Cada columna s'emmagatzema de manera independent, per la qual cosa és molt eficient per a consultes analítiques sobre grans volums de dades (per exemple, HBase o Cassandra).
1.5. NoSQL o Relacional
El primer que cal dir és que no és una decisió superimportant: podem dissenyar qualsevol cosa amb els dos models. Està clar que en determinades situacions ens facilita més la vida un model o l'altre, però en altres és exactament igual.
El que realment importa, triem el model que triem, és fer un bon disseny. Poc importa encertar el model si després el dissenyem malament.
1.6. Diferències entre NoSQL i Relacional. Nomenclatura
| SQL | NoSQL |
|---|---|
| Base de dades | Base de dades |
| Taula | Col·lecció |
| Fila | Document |
| Columna | Camp |
| Estructura tabular | Objectes JSON |
Exemple: plataforma online de cursos d'idiomes
Imaginem que tenim una plataforma online de cursos d'idiomes i triem emprar un model relacional, però dissenyem malament i fem això:
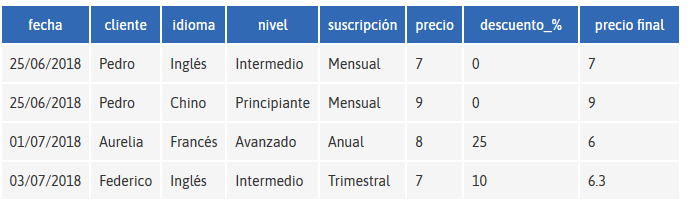
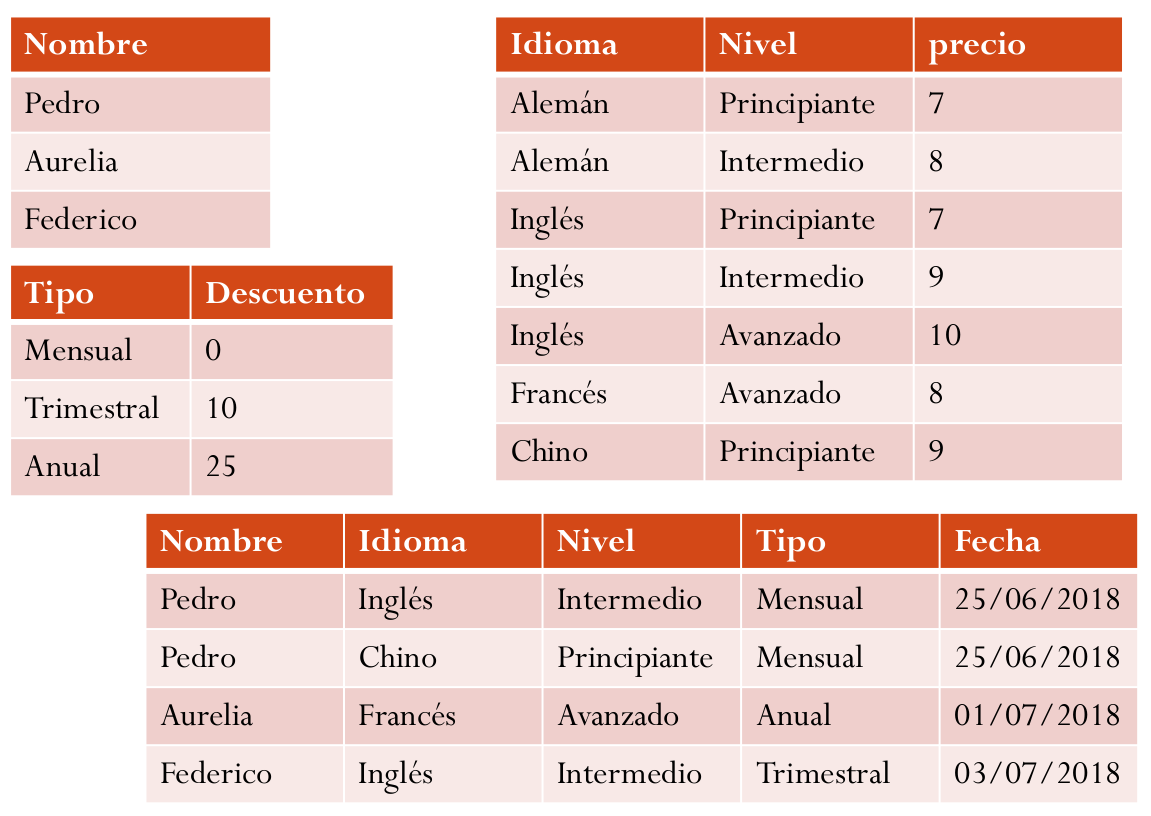
Com veiem, tenim problemes de falta de normalització. Ara normalitzem:
En NoSQL tenim l'alternativa desnormalitzada:
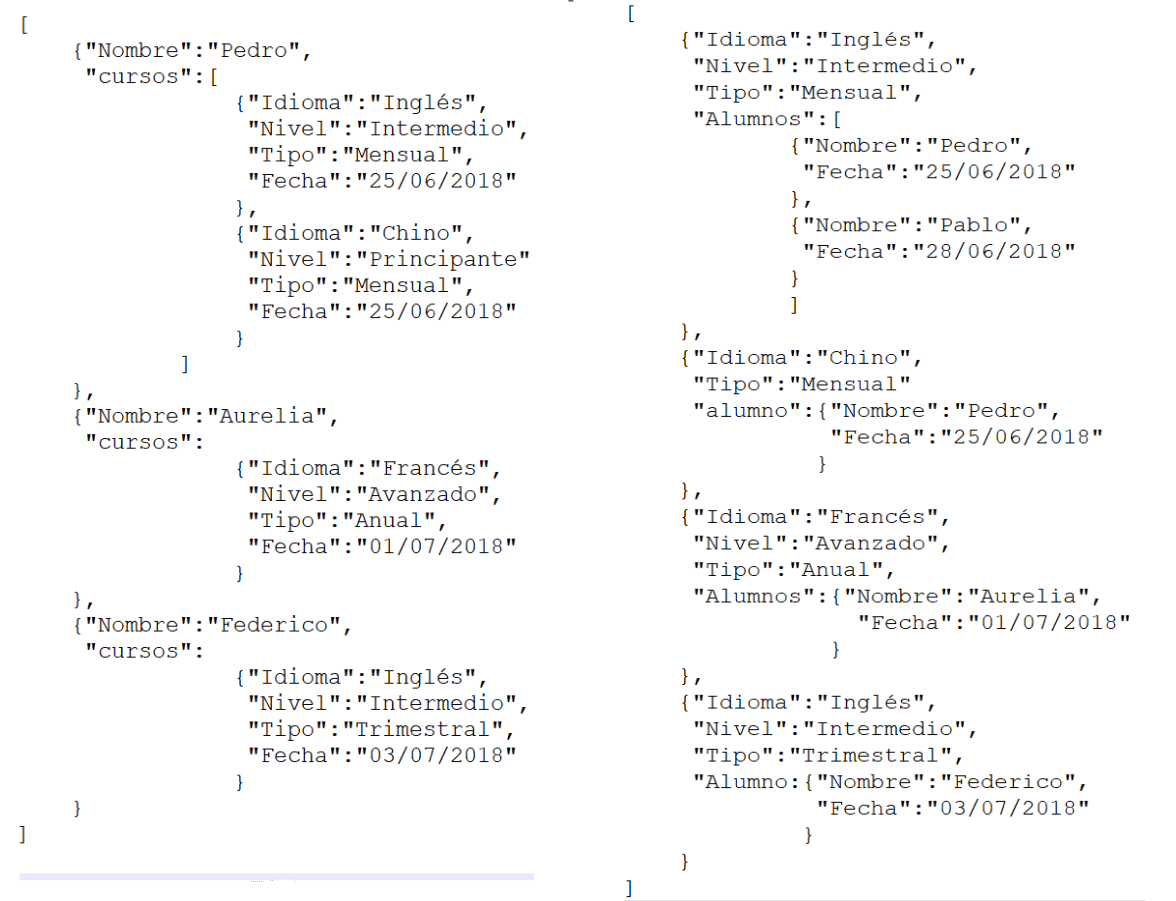
Les dues implementacions són vàlides.
1.6.1. Diferències NoSQL i Relacional
- No utilitzen SQL per a les consultes.
- No utilitzen estructures d'emmagatzematge fixes per a guardar la informació: fan ús d'altres models, com sistemes clau-valor, grafs o objectes.
- No solen permetre JOIN. En tindre un volum de dades extremadament gran, resulta incòmode utilitzar JOIN perquè sobrecarrega el sistema. La solució a aquest problema pot ser la desnormalització o fer el JOIN per programari en la capa d'aplicació.
- Arquitectura distribuïda. Les bases de dades relacionals solen estar centralitzades en una màquina o amb estructura client-servidor. Però els sistemes NoSQL poden contenir la informació compartida entre diverses màquines mitjançant taules hash distribuïdes.
1.6.2. Comparativa Relacional vs NoSQL
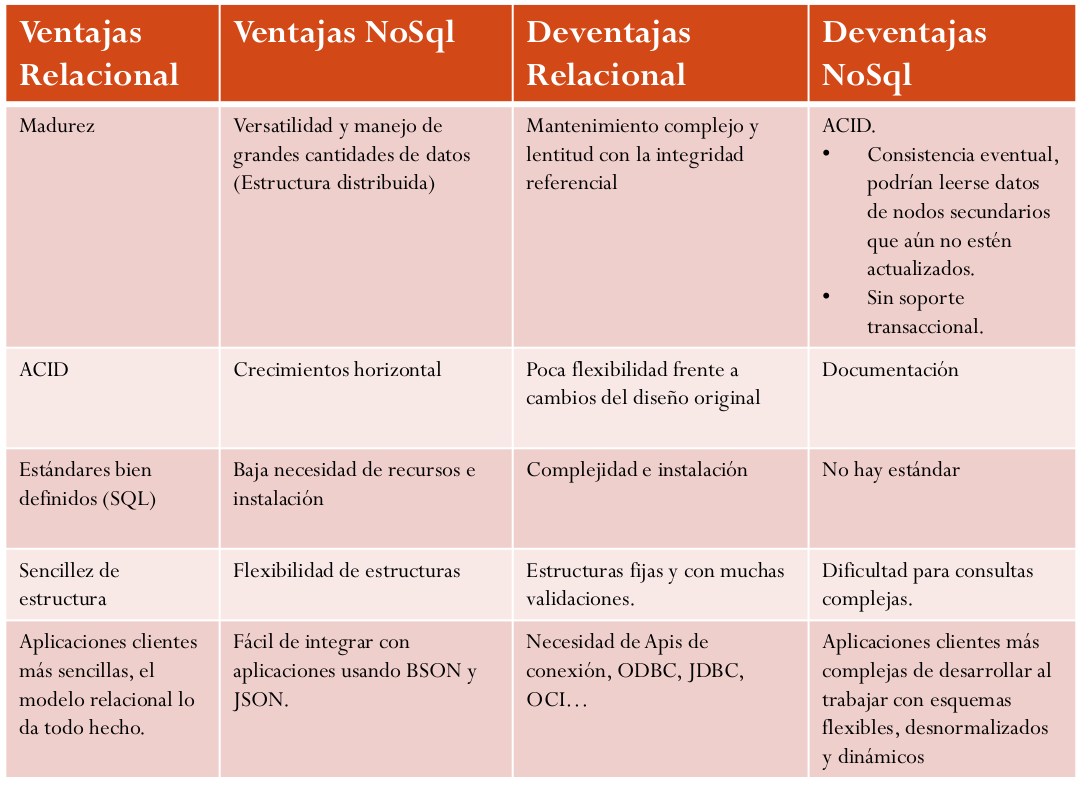
1.7. Què ofereix NoSQL
- Són idònies si les dades no segueixen una estructura fixa.
- No garanteixen els principis ACID.
- Model flexible. Milloren la flexibilitat i l'escalabilitat respecte de les BD SQL. Les dades que utilitzen les nostres aplicacions web, mòbils o socials estan sota canvis constants.
- Versatilitat. La modificació és més senzilla que en els models relacionals: a l'hora de modificar o introduir nous tipus de dades no cal modificar completament l'estructura de la base de dades.
- Alt rendiment. La velocitat és un dels factors més importants.
1.8. Quan triar NoSQL
- Quan l'escalabilitat en un model relacional no és viable o és molt costosa, tant a nivell tècnic com de costos.
- Quan el sistema té pics d'ús molt elevats per part dels usuaris.
- Quan el nombre de dades creix ràpidament en situacions puntuals, arribant a superar el terabyte d'informació.
- Quan la informació no és homogènia: en cada inserció podem tindre camps diferents.
- Quan ens interessa més la velocitat de les lectures que la seguretat de l'escriptura.
- Quan no tenim necessitat d'una gran normalització i podem tindre-ho desnormalitzat.
1.9. Entorns NoSQL més usuals
- Xarxes socials: quasi obligatori.
- Desenvolupament web: per la poca uniformitat de la informació que hi ha a Internet; tot i que també pot emprar-se SQL.
- Desenvolupament mòbil: per la tendència (en creixement) del Bring Your Own Device.
- Big Data: per l'administració de grandíssimes quantitats d'informació i la seua evident heterogeneïtat.
- Cloud (XaaS): Everything as a Service. NoSQL pot adaptar-se quasi a qualsevol necessitat del client i les seues particularitats.
1.10. Exemples de quan podem triar cada model
Casos d'ús
- Quan el nostre pressupost no es pot permetre grans màquines i ha de destinar-se a màquines de menor rendiment → NoSQL.
- Quan les estructures de dades que manegem són variables, o no la tenim clara inicialment → NoSQL.
- Anàlisi de grans quantitats de dades en mode lectura → NoSQL.
- Captura i processament d'esdeveniments → NoSQL.
- Botigues en línia amb motors d'intel·ligència complexos → NoSQL.
- Quan les dades han de ser consistents sense possibilitat d'error → base de dades relacional, SQL.
- En quasi tots els altres casos → SQL.
Resum
En NoSQL, les dades es recuperen, en general, de forma més ràpida que en el model relacional; no obstant això, les consultes que es poden realitzar són més limitades. La complexitat es trasllada a l'aplicació.
- Si la teua aplicació requereix suport transaccional, has d'usar un model relacional: no cal inventar la roda.
- NoSQL no és adequat per a aplicacions que generen informes amb consultes complexes (necessitat de JOIN), encara que hi ha operacions NoSQL que permeten paral·lelitzar operacions complexes com agregacions, filtres, etc.
- La tendència actual és cap a la combinació de sistemes SQL i NoSQL.
1.11. MongoDB
MongoDB és un gestor de dades estructurat sota NoSQL que compta amb un format d'emmagatzematge de documents en un format similar al JSON (JavaScript Object Notation). Està escrit en llenguatge C++, és multiplataforma, de codi obert i completament gratuït.
Els seus orígens es remunten a la fi de l'any 2007, quan era un projecte intern d'una empresa anomenada 10gen. El nom Mongo ve de la paraula anglesa humongous, que significa «enorme, extraordinàriament gran». El seu disseny va ser desenvolupat per a una aplicació d'Internet que l'empresa desenvolupava, i no va ser fins a l'any 2009 quan decideixen alliberar-lo en format OpenSource.
MongoDB compta amb un emmagatzematge flexible basat en JSON. A més, té suport per a la creació d'índexs des de qualsevol atribut. També cal destacar el seu alt rendiment per a consultes i actualitzacions, i la seua capacitat de creixement, replicació i escalabilitat.
MongoDB és ideal per a crear aplicacions en línia que requerisquen el registre de diverses dades, o per a la creació i disseny de programari flexible quant al tractament d'alts volums d'informació. Les bases construïdes sota aquest disseny poden rebre centenars de milers de lectures per segon sense que el rendiment es veja afectat.
Què ofereix MongoDB
- Orientada a documents (JSON).
- No segueix cap esquema (schemaless).
- Disposa d'una consola (shell) construïda sobre JavaScript, la qual cosa permet executar moltes de les seues funcions.
- Àmpliament utilitzada en aplicacions per a Internet i de Big Data.
- Escriptura ràpida: les bases de dades documentals prioritzen la disponibilitat d'escriptura per damunt de l'estricta consistència de les dades.
- Llenguatge de consultes avançat: els seus mètodes d'agregació per a Big Data són dels millors que hi ha.
- Alta disponibilitat: la replicació dels sets i el balanceig de càrrega és molt senzill i es fa en 4 passos.
- Escalabilitat horitzontal: alçar un clúster és senzill.
- Consola JS: es treballa en aquest llenguatge per als comandos de Mongo.
1.12. JSON: JavaScript Object Notation
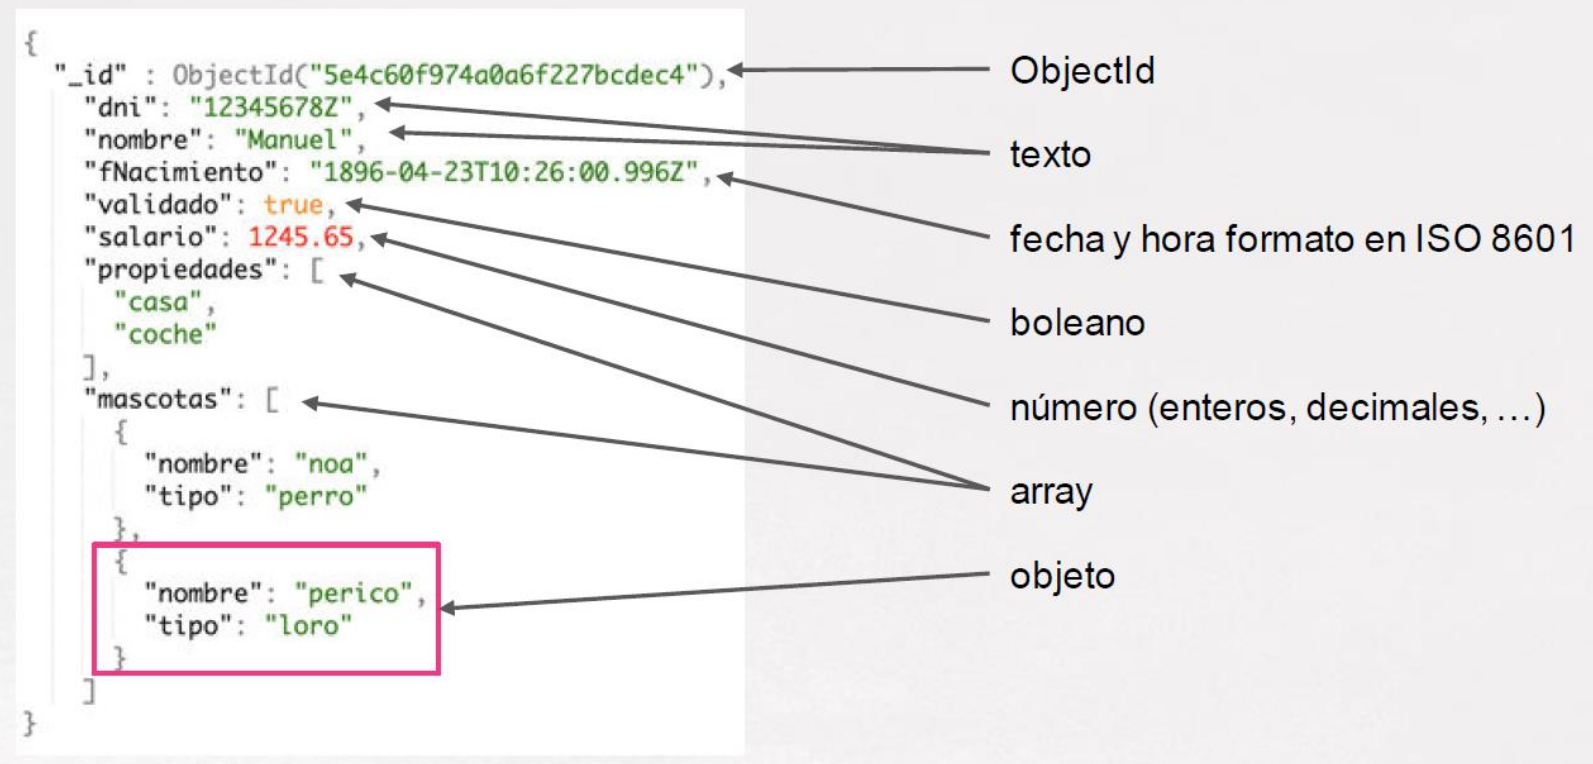
És un format de text senzill per a l'intercanvi de dades. Presenta una alternativa a XML perquè és més senzill de llegir i escriure. A més, està suportat per un gran nombre de llenguatges.
Un objecte JSON està format per un o diversos parells clau: valor.
La sintaxi de JSON és molt senzilla: partim de la dupla identificador: valor i, segons l'estructura, formarem variables, arrays, etc.
- Creació d'arrays amb claudàtors (
[]). - Creació d'objectes amb claus (
{}). - Separació del nom i assignació de valor amb dos punts (
:). - Separació de valors amb coma (
,).
1.13. Modelat Mongo
1.13.1. Modelat de dades
El model NoSQL és àgil i flexible i val tot. Com ja hem vist, accepta qualsevol cosa i qualsevol estructura:
- Podem tindre un E-R de partida i el seu disseny conceptual (traducció). És el més recomanable, encara que si tenim un model gran amb moltes relacions, és una pista que potser hauríem d'usar el model relacional i no NoSQL.
- També podem no tindre cap model i anar afegint estructures sobre la marxa, generalment quan ens decantem per NoSQL és perquè no hi ha moltes entitats ni les relacions són massa importants.
Al final sempre acabarem dissenyant un model quan el tinguem clar, però tenim la flexibilitat de no requerir un model predefinit, almenys al principi.
1.13.2. Opcions de modelat
En Mongo disposem de dues estructures diferents per a dissenyar relacions en les nostres col·leccions:
Opcions de modelat
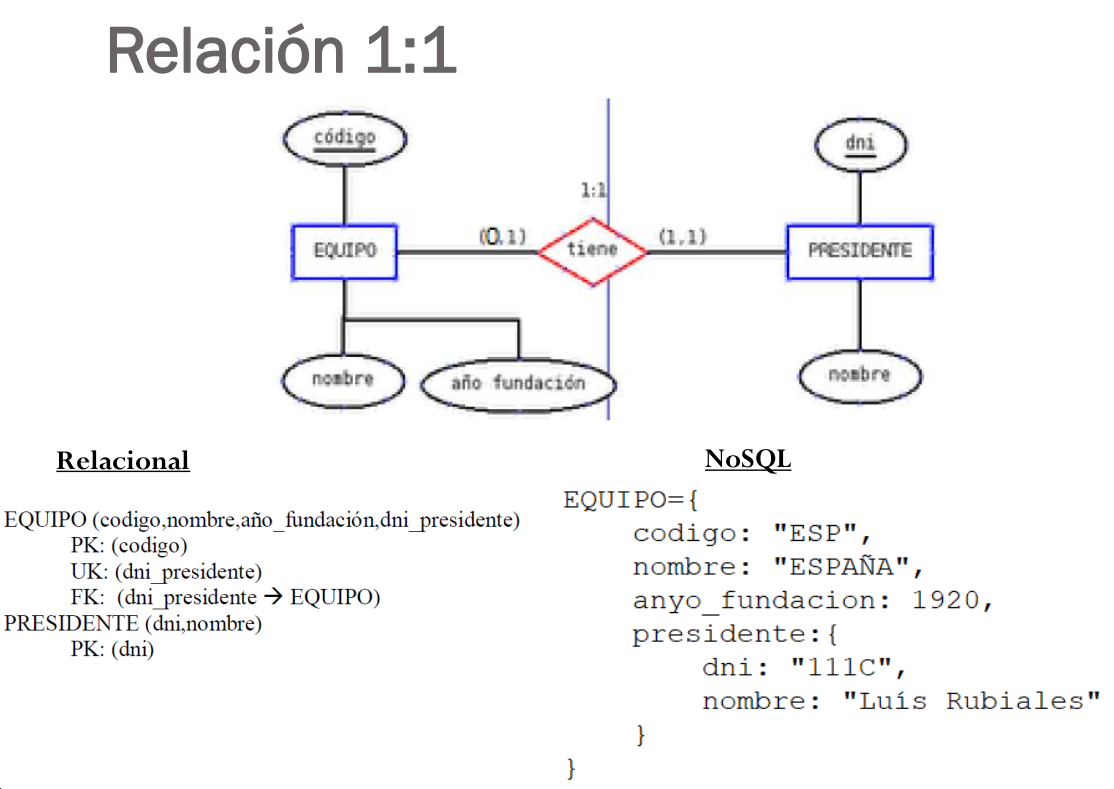
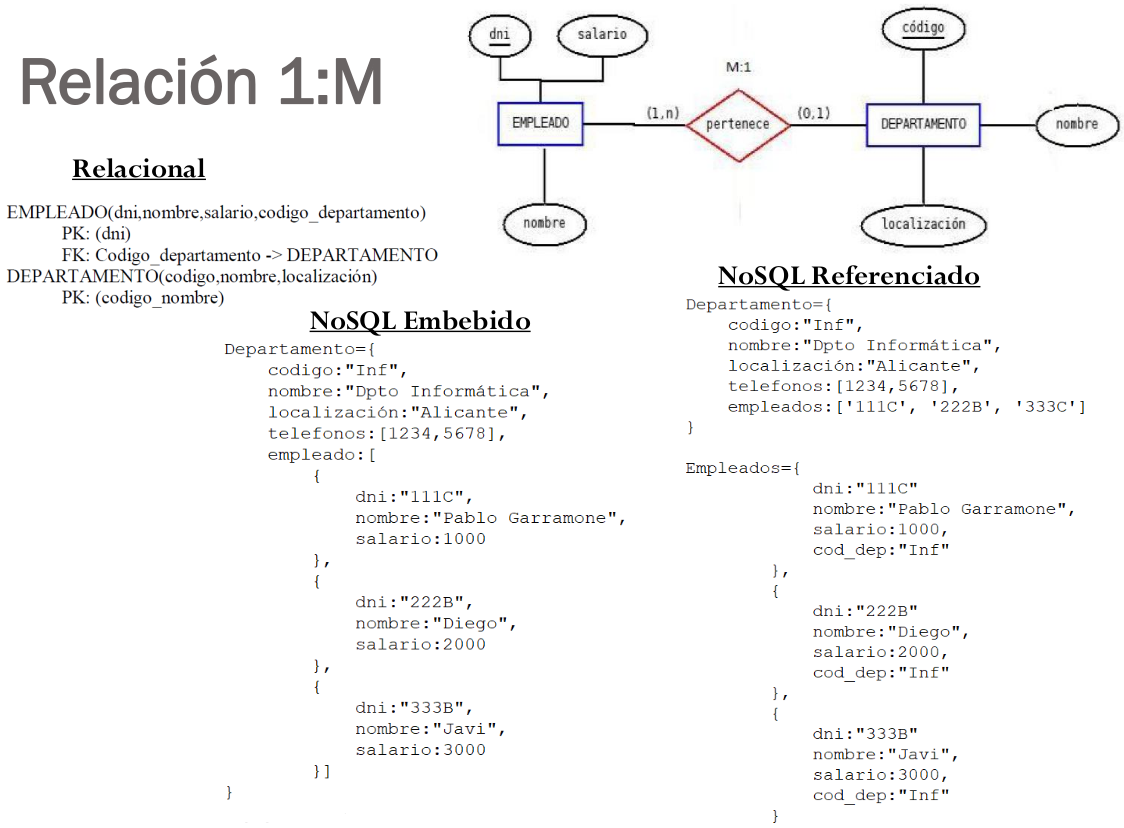
El que anomenaríem entitats en el disseny conceptual: en aquest cas tindríem una entitat dins d'una altra formant una sola col·lecció. Són els subdocuments.
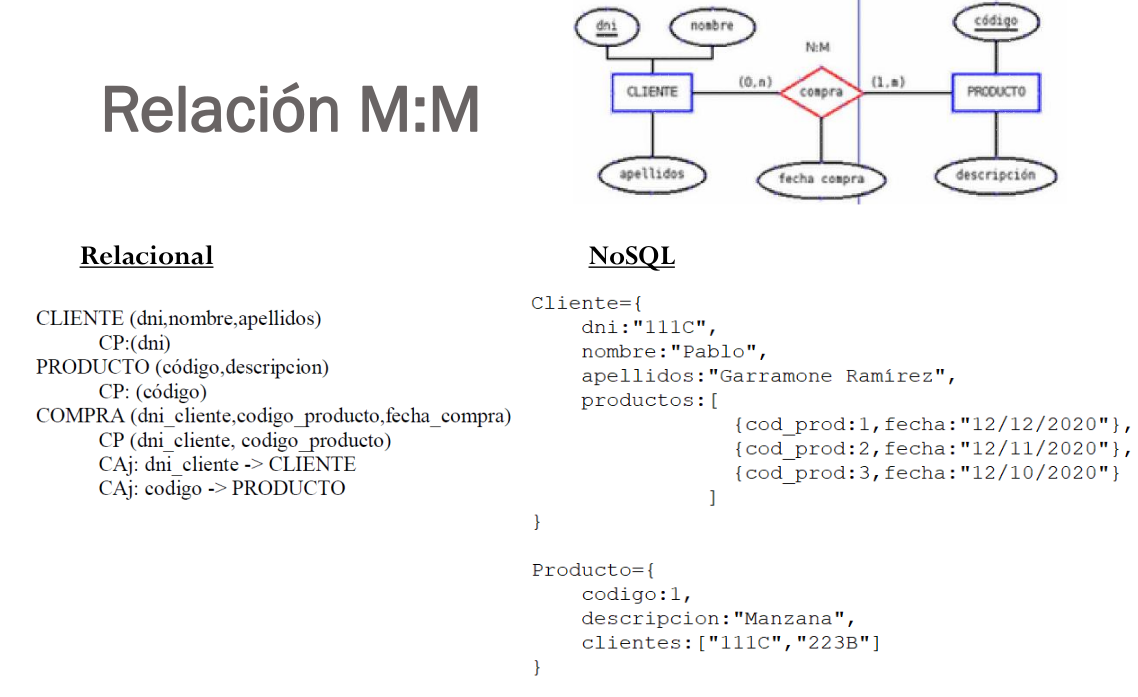
Quan ens interessa tindre les entitats separades, referenciem d'una forma semblant a com ho fem en el model relacional, amb unes foreign key simulades. En aquest cas haurem de tindre alguna cosa semblant a una clau primària (per defecte Mongo té el camp _id).
NoSQL està pensat per a embeure, però tampoc podem crear un document infinit ni repetitiu: a vegades ens convindrà referenciar, simulant les famoses FK (encara que moltíssim menys restrictives). Com veurem, les col·leccions poden tindre PK i UK.
Triar entre embeure o referenciar depèn totalment de l'aplicació:
- Com treballarem amb les dades.
- Com preveiem que vagen a evolucionar.
- Com creixen.
- Quan s'hi accedeix i a quines exactament.
- Com volem emmagatzemar les dades.
1.13.3. Embeure o referenciar
- En les relacions 1:1 interessa embeure, ja que així tenim tota la informació en la mateixa col·lecció, la qual cosa facilita la consulta.
- En una relació 1:M, dependrà de la relació:
- Si l'element de l'1 no es relaciona amb molts del costat M, ens pot interessar embeure, ja que sempre facilitarà la consulta.
- Però si es pot relacionar amb molts (1 milió, per exemple) tindrem dos problemes que, si es donen, faran que siga millor referenciar:
- De grandària: cal anar amb compte perquè Mongo té una limitació de 16 MB per document i no podrem inserir-lo.
- De cerca: si tenim tants subelements i hem de fer una consulta just per l'últim, no serà gens òptim; en aquest cas interessarà referenciar.
- Si requerim moltes consultes sobre els subelements exclusivament, pot interessar-nos tindre-ho en una col·lecció solta, per la qual cosa serà millor referenciar.
- En les relacions M:M, normalment serà convenient referenciar, perquè si un document es relaciona amb molts de l'altra col·lecció, aquest es repetirà en cadascun dels documents relacionats, la qual cosa generarà una tremenda redundància.
- Per norma general hem d'embeure, de manera que tinguem el màxim d'informació possible dins del mateix document, evitant JOIN, ja que en Mongo l'atomicitat és per document i els JOIN no són trivials.
- Si el subdocument embegut es repeteix moltíssimes vegades o realitzem cerques exclusives sobre ell, llavors és millor referenciar.
- Si la llista de subdocuments creixerà indiscriminadament, és millor referenciar (tinguent en compte la limitació dels 16 MB), ja que si es nia massa informació la consulta és ineficient.
| Embeure | Referenciar |
|---|---|
| Xicotets subdocuments | Grans subdocuments |
| Lectura ràpida: tota la informació en un sol document | Lectura òptima si embeguts hi haguera molts subdocuments. Inconvenient del JOIN |
| Documents que creixen en xicotetes quantitats o no canvien regularment | Documents que creixen en gran quantitat |
| Escriptures òptimes si no s'actualitza informació relacionada | Escriptures ràpides: en actualitzar informació relacionada es fa directament sense haver de recórrer la col·lecció externa |